Przerobiony model językowy liczy litery w słowach: metoda byteification z Nature
Wiele dużych modeli językowych twierdzi, że w słowie „strawberry” są dwie litery „r”, choć są trzy. Nature opisuje byteification - metodę przerabiania modeli na pracę na bajtach.
- Większość dużych modeli językowych dzieli tekst na tokeny, czyli ciągi liter, więc nie widzi pojedynczych znaków w słowie.
- Praca w Nature z 7 października 2026 roku opisuje byteification: metodę, która przerabia istniejące modele z tokenami na modele działające na poziomie bajtów.
- Konwersja przebiega w dwóch etapach i wymaga minimalnego dodatkowego treningu.
- Według autorów przerobione modele przewyższają wcześniejsze podejścia bajtowe i dobrze radzą sobie z zadaniami na poziomie znaków.
- Abstrakt nie podaje wyników liczbowych, więc skali poprawy nie da się z niego ocenić.
Słowo „strawberry” zawiera literę „r” trzy razy, ale zapytane o to, wiele dużych modeli językowych (LLM) odpowiada, że dwa razy. Ten błąd ma konkretną przyczynę. Większość modeli koduje słowa jako tokeny, czyli ciągi liter. Dzięki temu osiągają świetne wyniki w wielu zadaniach, ale nie mają dostępu do pojedynczych znaków, które składają się na każde słowo.
Przeczytałem abstrakt pracy oraz towarzyszący jej komentarz w Nature (dział News & Views). Pełny tekst artykułu jest płatny, więc poniżej opisuję tylko to, co potwierdzają te dwa źródła.
Dlaczego token przeszkadza w liczeniu liter
Model językowy nie czyta tekstu litera po literze. Dzieli go na tokeny, którymi najczęściej są całe słowa albo ich fragmenty. Abstrakt nazywa to tokenizacją na podsłowa.
Autorzy zwracają uwagę, że taki podział zasłania drobne szczegóły. Ma to znaczenie zwłaszcza w danych naukowych, na przykład w kodzie komputerowym i sekwencjach biologicznych, gdzie sens zależy od pojedynczych znaków albo bajtów.
Bajty to binarne sekwencje, w które zapisuje się tekst. Modele pracujące bezpośrednio na takim zapisie nie mają opisanego problemu. Według autorów do tej pory ustępowały jednak modelom opartym na podsłowach.
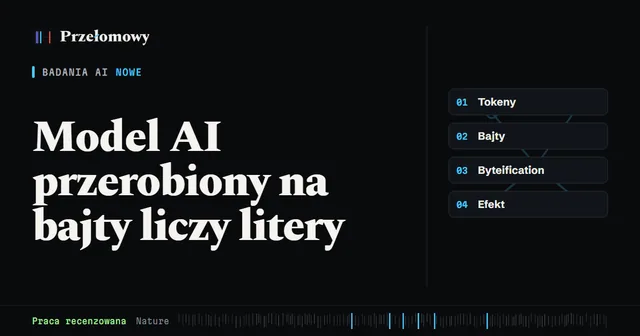
- Tokeny: Zwykły model dzieli tekst na tokeny i nie widzi pojedynczych znaków
- Bajty: Tekst da się zapisać jako ciągi bajtów, bez utraty szczegółów
- Byteification: Istniejący model z tokenami jest przerabiany na bajtowy w dwóch etapach
- Efekt: Model zachowuje zdolność odczytu pojedynczych znaków
Źródło: Minixhofer i in., Nature, 2026
Co zrobili autorzy
Zespół proponuje ogólną metodę tworzenia bajtowych modeli językowych o nazwie byteification. Zamiast trenować taki model od zera, przerabia się istniejący model oparty na podsłowach. Abstrakt opisuje to jako dwuetapową procedurę konwersji, która wymaga minimalnego dodatkowego treningu.
Według autorów powstałe modele:
- przewyższają wcześniejsze podejścia bajtowe,
- dobrze radzą sobie z zadaniami wymagającymi rozumowania na poziomie znaków,
- działają z praktyczną szybkością wnioskowania,
- można w nich wykorzystać ekosystem narzędzi zbudowany wokół modelu źródłowego.
Komentarz w Nature streszcza to krótko: przerobione modele mogą osiągać konkurencyjne wyniki i jednocześnie zachowują zdolność odczytu pojedynczych znaków.
Czego z tych źródeł nie wiadomo
Abstrakt i komentarz nie podają konkretnych liczb: ani dokładności w zadaniach na literach, ani porównań z modelami opartymi na tokenach, ani szybkości działania. Zwroty takie jak „konkurencyjne wyniki” czy „zbliżają się do możliwości” opisują więc kierunek, a nie wielkość poprawy. Nie wiem też, jakie modele wyjściowe przerabiano i jak duże były. Te informacje trzeba sprawdzić w pełnym tekście pracy.
Autorzy deklarują, że ich wyniki usuwają długotrwałą barierę wydajnościową dla modeli bajtowych. Pokazują też, że modele pracujące na surowym zapisie tekstu mogą skalować się konkurencyjnie. To teza autorów, a nie niezależne potwierdzenie. W komentarzu zaznaczono, że autorzy nie zgłaszają konfliktu interesów.
Skąd w ogóle biorą się tokeny i jak model przewiduje kolejne słowo, wyjaśniam w tekście Jak działają duże modele językowe.
Pytania i odpowiedzi
Dlaczego modele językowe mylą się przy liczeniu liter?
Większość z nich koduje słowa jako tokeny, czyli ciągi liter, a nie pojedyncze znaki. Przez to nie mają bezpośredniego dostępu do liter, z których składa się słowo, co widać na przykładzie „strawberry”.
Co to jest byteification?
To metoda opisana w Nature, która przerabia istniejący model językowy oparty na tokenach na model operujący na bajtach. Odbywa się to w dwóch etapach i z minimalnym dodatkowym treningiem.
Czy przerobione modele są tak dobre jak zwykłe?
Autorzy piszą, że ich wyniki są konkurencyjne i że modele zbliżają się do możliwości systemów opartych na podsłowach. Abstrakt nie podaje jednak liczb, więc trudno ocenić, jak duża jest różnica.
Do czego przydaje się praca na bajtach?
Według autorów szczególnie tam, gdzie znaczenie zależy od pojedynczych znaków, na przykład w kodzie komputerowym albo sekwencjach biologicznych.
Źródła
- Minixhofer B. i in., Retrofitting language models to operate over bytes, Nature, 2026-10-07
- Nature - Retrofitted LLM can count the letter 'i's in 'artificial intelligence', 2026-10-07
Piotr Olszewski
Autor Przełomowego. Codziennie czyta prace z arXiv, Nature, Science i komunikaty uczelni, a opisuje tylko te, które coś zmieniają. Każdą liczbę podaje ze źródłem.
Jak wybieram i sprawdzam prace →Widzisz błąd albo nieścisłość? Napisz - poprawię i dopiszę datę aktualizacji.