Jak działają duże modele językowe (LLM): od transformera po modele rozumujące
Duże modele językowe uczą się przewidywać kolejne słowo. Trenowanie GPT-2 w 2019 roku kosztowało 50 tys. dolarów, a PaLM-a w 2022 roku - 8 mln dolarów.
- Duży model językowy (LLM) to sieć neuronowa wytrenowana na ogromnej ilości tekstu, zwykle oparta na architekturze transformera przedstawionej w 2017 roku.
- Modele z rodziny GPT najpierw uczą się przewidywać następne słowo, a potem są dostrajane, by wykonywały polecenia i działały jak asystenci.
- Trenowanie GPT-2 (1,5 mld parametrów) w 2019 roku kosztowało 50 tys. dolarów, PaLM-a (540 mld parametrów) w 2022 roku - 8 mln dolarów.
- Na zadaniach z eliminacji do Międzynarodowej Olimpiady Matematycznej GPT-4o uzyskał 13% skuteczności, a model rozumujący o1 - 83%.
- Wiarygodność modeli ogranicza m.in. stronniczość lub błędy w danych treningowych oraz halucynacje.
Duży model językowy (ang. large language model, LLM) to model sztucznej inteligencji, zwykle sieć neuronowa, wytrenowany na ogromnej ilości tekstu. Potrafi generować, streszczać, tłumaczyć i analizować teksty. Na takich modelach działa wiele współczesnych chatbotów, m.in. ChatGPT, Claude, Gemini, Grok, Qwen i DeepSeek.
Ten tekst nie opisuje jednej pracy naukowej. To przegląd podstaw, oparty na angielskiej i polskiej wersji hasła w Wikipedii. Porównałem obie, a w jednym miejscu (data premiery modelu o3) różnią się ze sobą, więc tej daty nie podaję.
Skąd się wzięły duże modele językowe
Zanim w 2017 roku pojawiły się modele oparte na transformerze, część modeli językowych uchodziła za duże na tle ówczesnych możliwości obliczeniowych. W 2001 roku model oparty na n-gramach, wytrenowany na 300 milionach słów, osiągnął najlepszy wówczas wynik perplexity w testach porównawczych.
Potem do głosu doszły sieci neuronowe. Po przełomie w klasyfikacji obrazów około 2012 roku podobne architektury zaczęto stosować do tekstu. W 2013 roku Mikolov przedstawił Word2Vec, a w 2016 roku Google przeniosło swój tłumacz na neuronowe tłumaczenie maszynowe z użyciem sieci rekurencyjnych.
Przełom nastąpił na konferencji NeurIPS w 2017 roku, gdzie badacze Google zaprezentowali transformera w pracy „Attention Is All You Need”. Opierał się on głównie na mechanizmie uwagi opracowanym w 2014 roku przez Bahdanau i współpracowników.
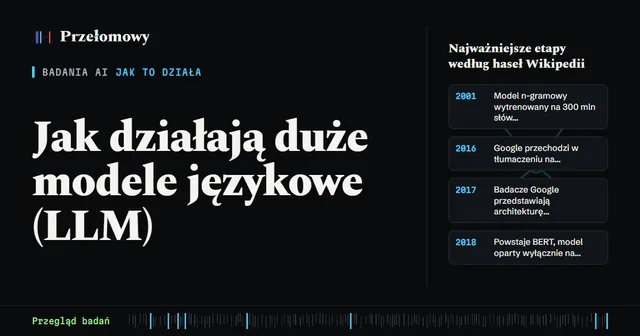
- 2001Model n-gramowy wytrenowany na 300 mln słów osiąga najlepszy wynik perplexity
- 2016Google przechodzi w tłumaczeniu na neuronowe tłumaczenie maszynowe
- 2017Badacze Google przedstawiają architekturę transformera
- 2018Powstaje BERT, model oparty wyłącznie na koderach
- 2019GPT-2 zwraca powszechną uwagę
- 2022ChatGPT, oparty na GPT-3.5, trafia do użytkowników
- 2024OpenAI wprowadza model rozumujący o1
- 2025DeepSeek publikuje DeepSeek R1 o otwartych wagach
- 2001: Model n-gramowy wytrenowany na 300 mln słów osiąga najlepszy wynik perplexity
- 2016: Google przechodzi w tłumaczeniu na neuronowe tłumaczenie maszynowe
- 2017: Badacze Google przedstawiają architekturę transformera
- 2018: Powstaje BERT, model oparty wyłącznie na koderach
- 2019: GPT-2 zwraca powszechną uwagę
- 2022: ChatGPT, oparty na GPT-3.5, trafia do użytkowników
- 2024: OpenAI wprowadza model rozumujący o1
- 2025: DeepSeek publikuje DeepSeek R1 o otwartych wagach
W 2018 roku powstał BERT, który jest modelem wyłącznie koderowym. Od 2023 roku zainteresowanie nim w badaniach zaczęło maleć na rzecz modeli opartych na dekoderach, takich jak GPT. Wielką uwagę zwrócił GPT-2 z 2019 roku: według Wikipedii OpenAI twierdziło, że początkowo uznało go za zbyt potężny, by udostępnić publicznie, z obawy przed nadużyciami. Szeroko opisywany w mediach stał się jednak dopiero ChatGPT z końca 2022 roku.
Jak model zamienia tekst na liczby
Algorytmy uczenia maszynowego przetwarzają liczby, nie tekst. Dlatego pierwszym krokiem jest tokenizacja. Ustala się słownik, każdej jego pozycji przypisuje się numer, a numerowi - wektor liczb (embedding). Stosuje się algorytmy takie jak kodowanie par bajtów (BPE) i WordPiece.
Przy BPE początkowym zbiorem są wszystkie pojedyncze znaki, także spacje i znaki interpunkcyjne. Potem najczęściej sąsiadujące ze sobą pary są kolejno łączone w dłuższe fragmenty, aż słownik osiągnie zadany rozmiar. Po wytrenowaniu tokenizera można zapisać w ten sposób dowolny tekst, o ile nie zawiera znaków spoza początkowego zbioru.
Przed trenowaniem dane zwykle się czyści: usuwa niskiej jakości, zduplikowane i toksyczne treści. Hasło zwraca uwagę na rosnący udział treści generowanych przez same modele. Wyfiltrowanie ich bywa trudne, a mogą obniżać jakość modeli, które się na nich uczą. Gdy naturalnych danych brakuje albo są zbyt słabe, bywa stosowana synteza danych.
Mechanizm uwagi i okno kontekstu
Transformer pozwala modelowi analizować relacje między wszystkimi elementami sekwencji jednocześnie, niezależnie od ich odległości. Mechanizm uwagi oblicza „miękkie” wagi dla każdego tokena z użyciem wielu „głowic uwagi”. Dla skali: najmniejszy GPT-2 (117 mln parametrów) miał dwanaście głowic i okno kontekstu liczące zaledwie około tysiąca tokenów.
Modele autoregresyjne, takie jak GPT, uczą się zgadywać dalszy ciąg sekwencji. Modele maskowane, jak BERT, uczą się odgadywać brakujące fragmenty. W obu przypadkach przewidywania wynikają z właściwości sekwencji w danych treningowych.
Alternatywą dla transformera są m.in. modele przestrzeni stanów, zaproponowane przez Peng i współpracowników w 2023 roku. Polska wersja hasła wspomina też o sieciach rekurencyjnych i architekturze Mamba.
Jak trenuje się model
Modele GPT są najpierw wstępnie trenowane na dużej ilości danych, by przewidywały następne słowo. Przed dostrojeniem większość LLM to właśnie takie predyktory następnego tokena. Dostrajanie nadaje im pożądane zachowanie.
- Wstępne trenowanie: Model uczy się przewidywać następne słowo na dużym zbiorze tekstów
- Dostrajanie instrukcjami: Uczenie nadzorowane uczy model wykonywania poleceń
- Model nagród: Osobny model uczy się przewidywać, który tekst ludzie wolą
- RLHF: Uczenie przez wzmacnianie dopasowuje LLM do modelu nagród
- Asystent: Model prowadzi dialog zgodnie z poleceniami użytkownika
Źródło: Wikipedia (en, pl): Large language model / Duży model językowy
Pierwszy z takich modeli, InstructGPT, czyli wersja GPT-3 dostrojona do poleceń, OpenAI pokazało w 2022 roku. ChatGPT był jego „siostrzanym” modelem, dostrojonym do tekstu w formie dialogu na bazie GPT-3.5.
Ile to kosztuje
Trenowanie największych modeli wymaga ogromnej infrastruktury. Wikipedia podaje trzy przykłady kosztów. Trenowanie GPT-2 w 2019 roku kosztowało 50 tys. dolarów, dlatego na wykresie w milionach dolarów pokazuję dwa pozostałe modele.
| Megatron-Turing NLG 530B (2021) | 11 mln USD |
|---|---|
| PaLM (2022) | 8 mln USD |
Źródło: Wikipedia (en): Large language model
Wykres pokazuje kwoty z hasła w Wikipedii, bez rozbicia metodologii. Modele różnią się architekturą i skalą, więc porównanie jest orientacyjne. Wikipedia zaznacza też, że słowo „duży” jest nieostre: nie ma progu liczby parametrów, od którego model uznaje się za duży.
Rozmiar modelu i kwantyzacja
Modele trenuje się zwykle na liczbach zmiennoprzecinkowych pojedynczej lub połówkowej precyzji. Jedna liczba float16 zajmuje 2 bajty, więc miliard parametrów wymaga 2 gigabajtów. Największe modele mają ponad 100 mld parametrów, co wykracza poza możliwości większości sprzętu konsumenckiego. W 2021 roku Google Brain wydało Switch Transformer, jeden z pierwszych modeli językowych o ponad bilionie parametrów.
Dwa sposoby na obniżenie wymagań:
- Mieszanka ekspertów (MoE) - wiele wyspecjalizowanych sieci i mechanizm, który kieruje dane do najodpowiedniejszych. Dla każdego wejścia używana jest tylko część parametrów, co może obniżyć koszt wnioskowania.
- Kwantyzacja - zmniejszenie precyzji parametrów już wytrenowanego modelu przy zachowaniu większości jego wydajności. Najprostsza forma, czyli obcięcie parametrów do zadanej liczby bitów, oznacza znaczną utratę precyzji.
Niektóre modele o otwartych wagach da się pobrać i uruchomić lokalnie na komputerze osobistym. Inne działają wyłącznie w zdalnych centrach danych.
Od czatu do agenta
Zamiana LLM w chatbota polega na specjalizacji w rozmowie. Wejście użytkownika poprzedza się znacznikiem, np. „User:”, a model przewiduje tekst po „Assistant:”. Na początku rozmowy zwykle stoi tzw. prompt systemowy z nadrzędnymi instrukcjami.
Możliwości modelu rozszerzają m.in.:
- Prompting kilkoma przykładami (few-shot), opisany w 2020 roku przy GPT-3. Pozwala dostosować model do zadania bez dostrajania.
- Rozumowanie krok po kroku (chain-of-thought), opisane w pracy z 2022 roku. Model dostaje przykłady rozbijania problemu na etapy i naśladuje je, co poprawia poprawność odpowiedzi na dość złożonych pytaniach.
- RAG, czyli łączenie LLM z wyszukiwarką dokumentów. Model generuje odpowiedź na podstawie zapytania i znalezionych fragmentów.
- Użycie narzędzi, czyli wywoływanie zewnętrznych systemów (np. API albo wykonanie kodu) przez osobny program, który obserwuje wyjście modelu.
Sam LLM, jak zaznacza Wikipedia, zwykle nie jest autonomicznym agentem: nie pamięta wcześniejszych działań i nie planuje. Może nim zostać po dodaniu pamięci, opisu środowiska i narzędzi.
Modele rozumujące
Pod koniec 2024 roku pojawił się nowy kierunek: modele trenowane, by przed odpowiedzią generować analizę krok po kroku. OpenAI wprowadziło tę koncepcję modelem o1 we wrześniu 2024 roku.
| GPT-4o | 13 % |
|---|---|
| o1 | 83 % |
Źródło: Wikipedia (en, pl): Large language model / Duży model językowy
W styczniu 2025 roku chińska firma DeepSeek udostępniła DeepSeek-R1, model rozumujący o otwartych wagach i 671 mld parametrów. Według hasła osiąga wyniki porównywalne z o1 przy znacznie niższych kosztach. Otwartość wag pozwoliła badaczom analizować algorytm, choć dane treningowe pozostały niepublikowane.
Modele rozumujące zwykle zużywają więcej mocy obliczeniowej na jedno zapytanie niż tradycyjne LLM-y.
Ograniczenia i ryzyka
Jakość odpowiedzi zależy od danych: stronnicze lub błędne dane treningowe obniżają wiarygodność wyników. Modele mogą dziedziczyć i wzmacniać stronniczość, co bywa widoczne w nierównym traktowaniu grup demograficznych. Pojawiają się też halucynacje, czyli wiarygodnie brzmiące, ale nieprawdziwe wypowiedzi.
Polskie hasło opisuje także kwestie, które warto traktować ostrożnie jako doniesienia, a nie ustalone fakty:
- Według badania Sentio University z 2025 roku 48,7% z 499 dorosłych Amerykanów z utrzymującymi się problemami psychicznymi, którzy korzystali z LLM, deklarowało, że zwracało się do nich po terapię lub wsparcie emocjonalne.
- W 2025 roku podkreślano o 50% wyższy poziom sykofancji (przytakiwania użytkownikowi) niż u ludzi. Hasło podaje, że w GPT-5 odsetek nadmiernie pochlebnych odpowiedzi spadł z 14,5% w poprzedniej wersji do mniej niż 6%.
- Goldman Sachs w 2023 roku twierdził, że LLM mogą zwiększyć globalne PKB o 7% w ciągu dekady i wystawić na automatyzację pracę 300 mln osób. To prognoza, nie wynik pomiaru.
- W 2023 roku do sądów w USA wpłynęło kilka wniosków kwestionujących używanie danych chronionych prawem autorskim do trenowania modeli, a obrońcy powoływali się na zasadę fair use.
Wszystkie liczby w tym tekście pochodzą z haseł Wikipedii, a nie z własnych testów. Nie weryfikowałem ich w oryginalnych badaniach, więc przed powołaniem się na nie w cytowanej pracy warto sięgnąć do źródeł podanych w przypisach haseł.
Pytania i odpowiedzi
Czym jest duży model językowy?
To model sztucznej inteligencji, zwykle sieć neuronowa, wytrenowany na ogromnej ilości tekstu do zadań związanych z językiem, zwłaszcza generowaniem tekstu. Potrafi m.in. generować, streszczać, tłumaczyć i analizować teksty.
Co to jest transformer?
To architektura sieci neuronowej przedstawiona przez badaczy Google w 2017 roku w pracy „Attention Is All You Need”. Opiera się na mechanizmie uwagi, który pozwala modelowi przetwarzać zależności między wszystkimi elementami sekwencji jednocześnie.
Czym model rozumujący różni się od zwykłego LLM?
Model rozumujący jest trenowany, by przed odpowiedzią generować analizę krok po kroku. Na zadaniach z eliminacji do Międzynarodowej Olimpiady Matematycznej o1 uzyskał 83% skuteczności, a GPT-4o 13%, ale taki model zwykle zużywa więcej mocy obliczeniowej na zapytanie.
Czy model językowy można uruchomić na własnym komputerze?
Niektóre modele o otwartych wagach da się pobrać i uruchomić lokalnie. Największe modele, mające ponad 100 mld parametrów, wykraczają jednak poza możliwości większości sprzętu konsumenckiego.
Źródła
Piotr Olszewski
Autor Przełomowego. Codziennie czyta prace z arXiv, Nature, Science i komunikaty uczelni, a opisuje tylko te, które coś zmieniają. Każdą liczbę podaje ze źródłem.
Jak wybieram i sprawdzam prace →Widzisz błąd albo nieścisłość? Napisz - poprawię i dopiszę datę aktualizacji.