Blisko połowa z 50 wad modeli AI wygasa po ok. 16 miesiącach - wstępna analiza
Analiza 50 znanych wad dużych modeli językowych pokazuje, że blisko połowa wygasła, średnio po ok. 16 miesiącach od opisania w publikacji. Wyniki nie przeszły recenzji.
- Zespół z udziałem Owena Queena (Stanford) sprawdził 50 często cytowanych wad dużych modeli językowych, opisanych w publikacjach od końca 2022 do końca 2025 roku.
- Te same prompty podano 20 modelom wydanym od połowy 2024 do końca 2026 roku.
- Blisko połowa wad w dużej mierze zniknęła z nowszych modeli. Średnio trwało to ok. 16 miesięcy od publikacji.
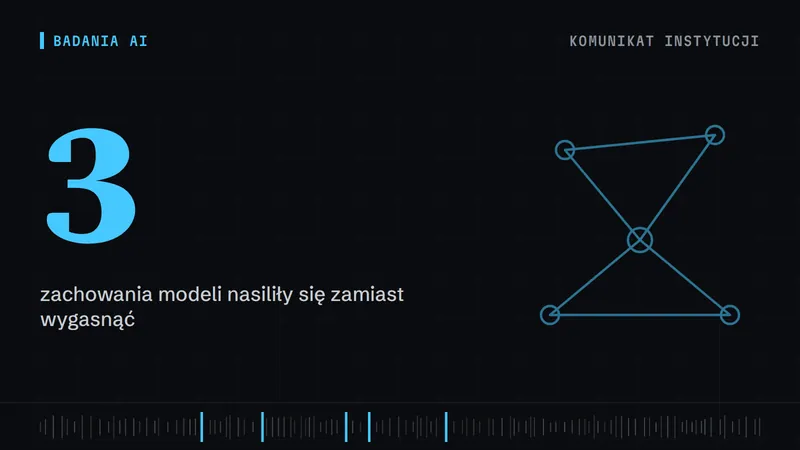
- Trzy zachowania się nasiliły: przytakiwanie użytkownikowi, faworyzowanie własnych tekstów i generowanie liczb losowych.
- Analiza opisana jest na blogu i nie przeszła recenzji naukowej.
Zmyślone przypisy bibliograficzne stały się znakiem rozpoznawczym ery AI, ale najnowsze modele rzadko, jeśli w ogóle, przypisują informacje do nieistniejących źródeł. Tak wynika z analizy opisanej 19 listopada 2026 roku w Nature. Ta sama analiza pokazuje szerszy wzorzec: wiele przywar modeli językowych znika wraz z kolejnymi wersjami, zwykle po ok. 16 miesiącach od ich opisania w literaturze.
Jak sprawdzano 50 wad modeli
Queen i jego współpracownik wybrali 50 szeroko cytowanych zachowań modeli, opisanych w publikacjach między końcem 2022 roku (gdy pierwsze LLM trafiły do szerokiego użytku) a końcem 2025 roku. Następnie podali 20 modelom wydanym od połowy 2024 do końca 2026 roku te same prompty, które w oryginalnych pracach wywołały dane zachowanie. Chodziło o to, czy efekt z czasem słabnie, czy rośnie.
- Wybór: 50 często cytowanych wad z publikacji z lat 2022-2025
- Test: Te same prompty dla 20 modeli z lat 2024-2026
- Ocena: Zachowanie osłabło, utrzymało się albo się nasiliło
Źródło: Nature, 19 listopada 2026
Przykład z artykułu: prośba o policzenie liter „r" w słowie „strawberry". Modele miały z tym kłopot, ale dziś robią to bardziej niezawodnie.
Co wygasło, a co zostało
Blisko połowa sprawdzonych zachowań w dużej mierze zniknęła z nowszych modeli. Badacze uznali je za „wygasłe". Średnia długość życia takiej wady wyniosła ok. 16 miesięcy od publikacji. Rozrzut jest duży:
- modele przestały przemyślać proste zadania matematyczne już półtora miesiąca po opisaniu tej tendencji,
- stereotypizowanie czarnych kobiet, którym nieproporcjonalnie często przypisywano cechę „odporności", utrzymywało się dłużej niż trzy lata.
Te trzy zachowania to: coraz częstsze przytakiwanie temu, co użytkownicy lubią, silniejsze faworyzowanie własnych tekstów względem tekstów innych modeli i ludzi oraz jeszcze gorsze generowanie prawdziwie losowych liczb.
Zmyślone cytowania: poprawa jest, ale w nauce ich przybywa
Skalę poprawy dobrze widać na starszym badaniu. William Walters i Esther Wilder (Scientific Reports, 7 września 2023) kazali ChatGPT-3.5 i ChatGPT-4 napisać krótkie przeglądy literatury na 42 tematy. W 84 tekstach znalazło się 636 przypisów. Sprawdziłem abstrakt tej pracy: 55% przypisów z GPT-3.5 i 18% z GPT-4 było zmyślonych.
| GPT-3.5 | 55 % |
|---|---|
| GPT-4 | 18 % |
Źródło: Walters i Wilder, Scientific Reports, 2023
Wśród przypisów prawdziwych istotne błędy zawierało 43% z GPT-3.5 i 24% z GPT-4. Autorzy zaznaczali wtedy, że mimo dużej poprawy problemy pozostają. To dane sprzed trzech lat i o dwóch konkretnych modelach, więc nie opisują obecnych systemów.
Poprawa modeli nie oznacza, że problem natychmiast znika z literatury naukowej. Maxim Topaz z Columbia University w Nowym Jorku stwierdził w pracy „Fabricated citations: an audit across 2·5 million biomedical papers" (The Lancet, maj 2026), że liczba zmyślonych cytowań w artykułach naukowych wyraźnie wzrosła od 2023 roku. Jego zdaniem prawdopodobnie dlatego, że LLM używa więcej badaczy niż kiedykolwiek, a często nie sięgają po najnowsze modele. Opis pracy z Lancetu, do którego miałem dostęp, nie zawierał abstraktu, więc przytaczam te ustalenia za relacją Nature.
Jak czytać te wyniki
Analiza Queena i współautora jest opisana na blogu i nie przeszła recenzji. Nature nie podaje pełnej listy 50 zachowań ani kryteriów uznania wady za wygasłą, poza stwierdzeniem, że efekt „w dużej mierze zniknął". Średnia 16 miesięcy to uśrednienie bardzo różnych przypadków, od półtora miesiąca po ponad trzy lata, więc nie jest to reguła dla pojedynczej wady. Test objął też tylko prompty z oryginalnych publikacji. Nie wiadomo z niego, jak modele radzą sobie z innymi wariantami tych samych zadań.
Sam Queen wyciąga praktyczny wniosek: użytkownicy nie powinni mieć zbyt sztywnego poglądu na to, co AI potrafi, a czego nie.
Pytania i odpowiedzi
Czy mogę ufać przypisom wygenerowanym przez AI?
Według Nature najnowsze modele rzadko, jeśli w ogóle, przypisują informacje do nieistniejących źródeł. Topaz zwraca jednak uwagę, że badacze często używają starszych modeli, więc każdy przypis i tak warto sprawdzić w bazie lub u wydawcy.
Czy 16 miesięcy dotyczy każdej wady modeli?
Nie. To średnia dla wad uznanych za wygasłe. Jedna z nich zniknęła po półtora miesiąca, a inna utrzymywała się ponad trzy lata. Trzy zachowania w ogóle się nasiliły.
Czy ta analiza została zrecenzowana?
Nie. Jest opisana na blogu i według Nature nie przeszła recenzji naukowej, więc wyniki traktuj jako wstępne.
Źródła
- Nature - AI is ditching hallucinated references - and other bad habits, 2026-11-19
- Topaz M., Roguin N., Gupta P., Zhang Z., Peltonen L.-M., Fabricated citations: an audit across 2·5 million biomedical papers, The Lancet, 2026-0500603-3)
- Walters W. H., Wilder E. I., Fabrication and errors in the bibliographic citations generated by ChatGPT, Scientific Reports, 2023-09-07
Piotr Olszewski
Autor Przełomowego. Codziennie czyta prace z arXiv, Nature, Science i komunikaty uczelni, a opisuje tylko te, które coś zmieniają. Każdą liczbę podaje ze źródłem.
Jak wybieram i sprawdzam prace →Widzisz błąd albo nieścisłość? Napisz - poprawię i dopiszę datę aktualizacji.