Duże modele językowe: transformer z 2017 r. i trening od 50 000 do 11 mln dolarów
Trening GPT-2 w 2019 r. kosztował 50 000 dolarów, a PaLM-a w 2022 r. 8 mln. Opisujemy, jak działają duże modele językowe: od tokenów po modele rozumujące.
- Duży model językowy (LLM) to sieć neuronowa wytrenowana na ogromnej ilości tekstu, zwykle oparta na architekturze transformera z 2017 r.
- Trening GPT-2 (1,5 mld parametrów, 2019) kosztował 50 000 dolarów, PaLM (540 mld, 2022) - 8 mln, a Megatron-Turing NLG 530B (2021) około 11 mln.
- Tekst trafia do modelu jako liczby (tokeny). W GPT-3.5 i GPT-4 słownik ma 100 258 pozycji.
- W teście z zadaniami kwalifikacyjnymi do Międzynarodowej Olimpiady Matematycznej GPT-4o miał 13% poprawnych odpowiedzi, a model rozumujący o1 - 83%.
- To przegląd haseł encyklopedycznych, a nie nowe badanie. Nie ma progu parametrów, od którego model uznaje się za "duży".
Największe modele językowe mają ponad 100 mld parametrów i wymagają infrastruktury, której nie postawisz w domu. Najtańszy z trzech przykładów podanych w haśle, GPT-2, kosztował w treningu 50 000 dolarów. Najdroższy, Megatron-Turing NLG 530B, około 11 mln. Przeczytałem angielskie hasła Wikipedii o dużych modelach językowych i o kodowaniu par bajtów (BPE) i zebrałem z nich to, co daje się sprawdzić: daty, liczby i mechanizmy.
Od modeli n-gramowych do transformera
Duży model językowy (LLM) to model uczenia maszynowego, zwykle sieć neuronowa, wytrenowany na ogromnej ilości tekstu. Potrafi generować, streszczać, tłumaczyć i analizować tekst. Na takich modelach opiera się wiele współczesnych czatbotów, m.in. ChatGPT, Claude, Gemini, Grok, Qwen i DeepSeek.
Przełom nastąpił w 2017 r. Na konferencji NeurIPS badacze Google'a przedstawili architekturę transformera w pracy "Attention Is All You Need". Opierała się głównie na mechanizmie uwagi opracowanym w 2014 r. przez Bahdanau i współpracowników. Rok później pojawił się BERT, model wyłącznie z częścią kodującą (encoder). Jego użycie w badaniach zaczęło spadać w 2023 r., gdy szybko poprawiły się modele z samym dekoderem, takie jak GPT, rozwiązujące zadania na podstawie promptu.
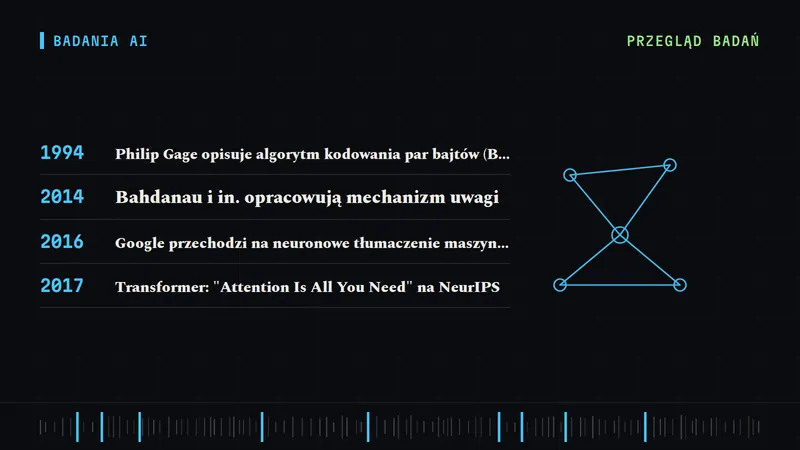
- 1994Philip Gage opisuje algorytm kodowania par bajtów (BPE)
- 2014Bahdanau i in. opracowują mechanizm uwagi
- 2016Google przechodzi na neuronowe tłumaczenie maszynowe
- 2017Transformer: "Attention Is All You Need" na NeurIPS
- 2018Pojawiają się BERT i GPT-1
- 2019GPT-2 przyciąga uwagę, bo OpenAI obawiało się jego publikacji
- 2020GPT-3, dostępny (stan na 2025) tylko przez API
- 2022ChatGPT, czatbot oparty na GPT-3.5
- 2024OpenAI przedstawia model rozumujący o1 (wrzesień)
- 2025DeepSeek wypuszcza DeepSeek-R1 (styczeń)
- 1994: Philip Gage opisuje algorytm kodowania par bajtów (BPE)
- 2014: Bahdanau i in. opracowują mechanizm uwagi
- 2016: Google przechodzi na neuronowe tłumaczenie maszynowe
- 2017: Transformer: "Attention Is All You Need" na NeurIPS
- 2018: Pojawiają się BERT i GPT-1
- 2019: GPT-2 przyciąga uwagę, bo OpenAI obawiało się jego publikacji
- 2020: GPT-3, dostępny (stan na 2025) tylko przez API
- 2022: ChatGPT, czatbot oparty na GPT-3.5
- 2024: OpenAI przedstawia model rozumujący o1 (wrzesień)
- 2025: DeepSeek wypuszcza DeepSeek-R1 (styczeń)
Co do GPT-2: hasło podaje, że OpenAI deklarowało początkowo, iż model jest zbyt potężny, by udostępnić go publicznie z obawy przed nadużyciami. To deklaracja firmy, a nie niezależna ocena.
Jak tekst zamienia się w liczby
Algorytmy uczenia maszynowego przetwarzają liczby, nie tekst, więc najpierw trzeba go przekonwertować. Ustala się słownik, każdej pozycji przypisuje liczbę całkowitą, a do niej wektor (embedding). Do tworzenia słownika służą m.in. BPE i WordPiece. Są też tokeny specjalne, np. [MASK] w BERT-cie czy [UNK] dla znaków spoza słownika.
BPE opisał w 1994 r. Philip Gage jako algorytm kompresji. Zastępuje najczęstszą parę bajtów nowym bajtem, którego nie było w danych, a tablica zamian pozwala odtworzyć oryginał. Oto przykład z hasła, ciąg "aaabdaaabac":
- Dane: Ciąg wejściowy: aaabdaaabac
- Para "aa": Najczęstsza para zastąpiona przez Z: ZabdZabac
- Para "ab": Zastąpiona przez Y: ZYdZYac
- Para "ZY": Zastąpiona przez X: XdXac
Źródło: Wikipedia (en): Byte-pair encoding
W modelach językowych algorytm zmodyfikowano. Nie chodzi już o maksymalną kompresję, tylko o zakodowanie tekstu w tokeny, czyli liczby naturalne. Zaczyna się od pojedynczych znaków, a najczęstsze sąsiednie pary skleja się w dłuższe tokeny, aż słownik osiągnie zadany rozmiar. W GPT-3.5 i GPT-4 słownik ma 100 258 pozycji: 100 000 z algorytmu BPE i 258 tokenów specjalnych. Wariant bajtowy, który najpierw zamienia tekst na UTF-8, gwarantuje, że zakoduje się dowolny tekst w tym formacie. Używają go m.in. RoBERTa, BART, DeBERTa i GPT-2.
Przed treningiem dane się też czyści: usuwa niskiej jakości, zduplikowane i toksyczne treści. Jeśli ilość naturalnych danych nie wystarcza, stosuje się dane syntetyczne. Hasło zauważa też, że rosnący udział treści generowanych przez LLM w sieci może w przyszłości wymagać ich odfiltrowywania. Są podobne do ludzkich, więc trudno je wychwycić, a bywają gorszej jakości.
Trening, dostrajanie i koszty
Modele typu GPT są najpierw pretrenowane, by przewidywać następne słowo na dużym zbiorze danych, a potem dostrajane. Dostrajanie nadzorowane uczy model wykonywania poleceń. W 2022 r. OpenAI pokazało InstructGPT, wersję GPT-3 dostrojoną w ten sposób. Inna technika, uczenie ze wzmocnieniem na podstawie ocen ludzi (RLHF), polega na wytrenowaniu modelu nagrody, który przewiduje, jaki tekst ludzie wolą. Potem sam LLM dostraja się tak, by tę nagrodę maksymalizować.
Koszty rosną razem z rozmiarem modeli. Według hasła:
- GPT-2 (1,5 mld parametrów, 2019): 50 000 dolarów,
- PaLM (540 mld parametrów, 2022): 8 mln dolarów,
- Megatron-Turing NLG 530B (2021): około 11 mln dolarów.
Słowo "duży" nie ma definicji liczbowej. Hasło podkreśla, że nie istnieje próg liczby parametrów, od którego model jest "duży". Podane kwoty to szacunki z encyklopedii, bez rozbicia na sprzęt, energię czy pracę ludzi.
Parametry, kwantyzacja i architektura ekspertów
Modele trenuje się zwykle na liczbach zmiennoprzecinkowych o pojedynczej lub połówkowej precyzji (float32 i float16). Jedna liczba float16 to 2 bajty, więc miliard parametrów zajmuje 2 GB. Największe modele mają zwykle ponad 100 mld parametrów, co wykracza poza możliwości większości sprzętu konsumenckiego. Dla porównania najmniejszy GPT-2 (117 mln parametrów) miał dwanaście głowic uwagi i okno kontekstu zaledwie 1 tys. tokenów.
W 2021 r. Google Brain udostępniło Switch Transformer, jeden z pierwszych modeli NLP przekraczających bilion parametrów. Według hasła największym otwartym modelem granicznym w lipcu 2026 r. jest Kimi K3 firmy Moonshot AI (2,8 bln parametrów). Anthropicowy Claude Mythos, niedostępny publicznie, ma według szacunków branżowych przytaczanych przez Financial Times około 8 bln parametrów. To szacunki, nie dane producenta.
Dwa sposoby na odchudzenie kosztów:
- Kwantyzacja - obniżenie precyzji parametrów wytrenowanego modelu, by zmniejszyć zapotrzebowanie na pamięć przy zachowaniu większości jakości. Najprostsza wersja obcina parametry do zadanej liczby bitów, ale traci sporo precyzji.
- Mieszanka ekspertów (MoE) - wiele wyspecjalizowanych sieci i mechanizm kierujący każde wejście do najbardziej odpowiednich. Zużywa tylko ułamek parametrów na każde zapytanie, więc obniża koszt wnioskowania.
Modele rozumujące i narzędzia
Pod koniec 2024 r. pojawiły się modele rozumujące, trenowane tak, by przed odpowiedzią generować analizę krok po kroku. OpenAI wprowadziło ten pomysł modelem o1 we wrześniu 2024 r., a o3 w kwietniu 2025 r. W zadaniach kwalifikacyjnych do Międzynarodowej Olimpiady Matematycznej GPT-4o osiągnął 13% poprawnych odpowiedzi, a o1 - 83%.
| GPT-4o | 13 % |
|---|---|
| o1 | 83 % |
Źródło: Wikipedia (en): Large language model
W styczniu 2025 r. chińska firma DeepSeek wypuściła DeepSeek-R1, otwarty (open-weight) model rozumujący o 671 mld parametrów. Według hasła osiąga wyniki porównywalne z o1 przy znacznie niższej cenie za token. Otwarte wagi pozwoliły badaczom analizować model, choć dane treningowe pozostały prywatne. Rozumowanie ma swoją cenę: takie modele zużywają więcej mocy obliczeniowej na jedno zapytanie niż tradycyjne LLM-y.
Sam LLM nie jest autonomicznym agentem. Można go jednak rozszerzyć o:
- wyszukiwanie dokumentów (RAG): zapytanie i dokumenty zamienia się na wektory, a model odpowiada na podstawie najbardziej podobnych,
- narzędzia: osobny program wychwytuje w odpowiedzi modelu specjalną składnię i wywołuje np. API lub kod,
- pamięć i planowanie, jak w metodach DEPS czy Reflexion.
Ograniczenia tego przeglądu
To zestawienie opiera się na hasłach encyklopedycznych, a nie na recenzowanej pracy z jedną próbą badawczą. Liczby kosztów i rozmiarów modeli pochodzą z kompilacji publicznych informacji, a część parametrów (np. GPT-4) nie została ujawniona przez OpenAI. Hasło ostrzega też, że stronnicze lub niedokładne dane treningowe mogą obniżać wiarygodność wyników modelu.
Pytania i odpowiedzi
Czy duży model językowy można uruchomić na własnym komputerze?
Niektóre modele z otwartymi wagami da się pobrać i uruchomić lokalnie. Pliki leżą wtedy na dysku, a podczas pracy wagi trzymane są w pamięci. Największe modele, powyżej 100 mld parametrów, przekraczają jednak możliwości większości sprzętu konsumenckiego.
Czym różni się BERT od modeli typu GPT?
BERT jest modelem maskowanym, wyłącznie z częścią kodującą: uczy się zgadywać brakujące słowa w ciągu. Modele autoregresyjne, jak GPT, uczą się przewidywać, jak ciąg się dalej potoczy.
Co oznaczają człony w nazwie modelu, np. 320B-A18B?
Zapis dotyczy parametrów. W przykładzie z hasła, GLM-5.3-Flash (320B-A18B), model ma 320 mld parametrów, z których 18 mld jest aktywnych w jednym przebiegu. Taki dodatkowy człon pojawia się przy modelach z mieszanką ekspertów.
Jak z modelu językowego zrobić czatbota?
Wejście użytkownika poprzedza się znacznikiem, np. "User:", a model ma przewidzieć tekst po stałym "Assistant:". Na początku rozmowy zwykle stoi kilka linijek nadrzędnych instrukcji, czyli tzw. prompt systemowy.
Źródła
Piotr Olszewski
Autor Przełomowego. Codziennie czyta prace z arXiv, Nature, Science i komunikaty uczelni, a opisuje tylko te, które coś zmieniają. Każdą liczbę podaje ze źródłem.
Jak wybieram i sprawdzam prace →Widzisz błąd albo nieścisłość? Napisz - poprawię i dopiszę datę aktualizacji.