Transformer w AI: jak mechanizm uwagi z 2017 roku zastąpił sieci rekurencyjne
Architektura transformer, opisana w pracy „Attention Is All You Need” (arXiv, 12 czerwca 2017), przetwarza tokeny równolegle, czego nie potrafiły sieci rekurencyjne, także LSTM.
- Transformer opiera się na wielogłowicowym mechanizmie uwagi. Oryginalną pracę „Attention Is All You Need” wysłano do arXiv 12 czerwca 2017.
- Sieci rekurencyjne, także LSTM, przetwarzają tokeny po kolei. Transformer w trakcie treningu liczy je równolegle.
- Koszt obliczeń i pamięci przy standardowej uwadze rośnie kwadratowo z długością sekwencji.
- W najmniejszym modelu GPT-2 wymiar osadzenia wynosi 768, głowic jest 12, a każda ma wymiar 64.
- BERT trafił do wyszukiwarki Google w październiku 2019, a ChatGPT na bazie GPT-3.5 stał się popularny pod koniec 2022.
Transformer to rodzina architektur sieci neuronowych, w której tekst, obraz lub dźwięk zamienia się w ciąg tokenów, a każdy token jest wektorem. W każdej warstwie token porównuje się z pozostałymi tokenami z okna kontekstu. Sygnał ważnych tokenów jest wzmacniany, mniej ważnych osłabiany. Praca „Attention Is All You Need”, której autorami byli badacze Google, trafiła do arXiv 12 czerwca 2017. Przeczytałem dwa hasła Wikipedii, o transformerze) i o mechanizmie uwagi), zestawiłem je ze sobą i poniżej streszczam, co z nich wynika.
To omówienie opiera się na dwóch hasłach encyklopedycznych, a nie na jednej pracy badawczej. Nie ma tu własnych testów ani nowych wyników. Szczegóły techniczne warto zweryfikować w oryginalnej pracy i w cytowanych w hasłach artykułach.
Dlaczego sieci rekurencyjne przestały wystarczać
Przed transformerami do modelowania sekwencji powszechnie używano sieci rekurencyjnych (RNN). Teoretycznie informacja z jednego tokenu może wędrować dowolnie daleko, ale w praktyce problem zanikającego gradientu sprawia, że stan modelu na końcu długiego zdania nie niesie dokładnych informacji o wcześniejszych tokenach. Przełomem był LSTM, opisany w raporcie technicznym z 1995 roku i formalnie opublikowany w 1997. Wprowadzał bramki, które łagodziły ten problem. LSTM pozostał standardem w modelowaniu długich sekwencji aż do publikacji transformerów w 2017 roku.
Miał jednak wadę: przetwarzał tokeny sekwencyjnie, od pierwszego do ostatniego, więc nie dało się go policzyć równolegle po wszystkich tokenach.
Tłumaczenie maszynowe i wąskie gardło
Modele seq2seq z 2014 roku składały się z dwóch sieci. Koder zamieniał zdanie w wektor, a dekoder zamieniał ten wektor z powrotem w sekwencję tokenów. Jeden z opisanych modeli tłumaczeniowych na dwóch LSTM miał 380 mln parametrów, a inny, oparty na jednostkach GRU, 130 mln. Informacja o całym zdaniu musiała się zmieścić w wektorze o stałym rozmiarze. Hasło podaje jako dowód, że odwrócenie zdania wejściowego poprawiało jakość tłumaczenia.
Mechanizm uwagi dodano do seq2seq właśnie po to, by ominąć to wąskie gardło. Model „RNN search” miał naśladować przeszukiwanie zdania źródłowego podczas dekodowania. W 2016 roku Google Translate przeszedł na Google Neural Machine Translation: osiem warstw LSTM w koderze i osiem w dekoderze. Według hasła jego opracowanie zajęło dziewięć miesięcy, a podejście statystyczne, które wyparł, rozwijano dziesięć lat.
Uwaga bez rekurencji
Modele z uwagą nadal były trudne do zrównoleglenia, więc nie dało się ich dobrze przyspieszyć na GPU. W 2016 roku „decomposable attention” zastosowała uwagę w sieciach feedforward i w zadaniu wnioskowania tekstowego (textual entailment) osiągnęła state of the art, mając o rząd wielkości mniej parametrów niż LSTM. Jeden z jej autorów, Jakob Uszkoreit, podejrzewał, że do tłumaczenia wystarczy uwaga bez rekurencji. Stąd tytuł późniejszej pracy. Hipoteza szła wbrew ówczesnej konwencji, a sceptyczny był nawet jego ojciec, Hans Uszkoreit, znany lingwista komputerowy.
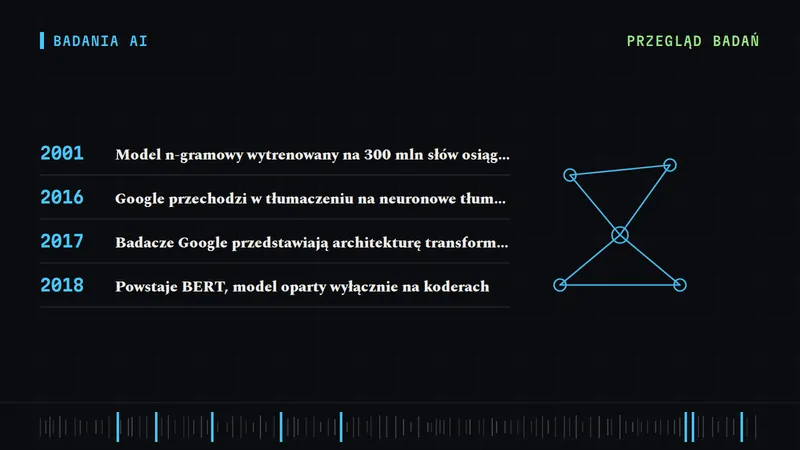
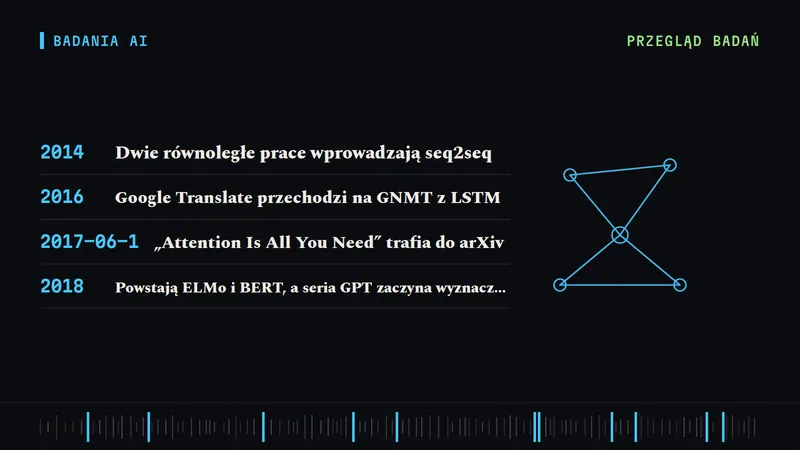
- 2014Dwie równoległe prace wprowadzają seq2seq
- 2016Google Translate przechodzi na GNMT z LSTM
- 2017-06-12„Attention Is All You Need” trafia do arXiv
- 2018Powstają ELMo i BERT, a seria GPT zaczyna wyznaczać state of the art w generowaniu języka
- 2019-10Google zaczyna używać BERT do zapytań w wyszukiwarce
- 2020Google Translate dostaje koder transformerowy z dekoderem RNN
- 2022ChatGPT na bazie GPT-3.5 wywołuje boom na duże modele językowe
- 2014: Dwie równoległe prace wprowadzają seq2seq
- 2016: Google Translate przechodzi na GNMT z LSTM
- 2017-06-12: „Attention Is All You Need” trafia do arXiv
- 2018: Powstają ELMo i BERT, a seria GPT zaczyna wyznaczać state of the art w generowaniu języka
- 2019-10: Google zaczyna używać BERT do zapytań w wyszukiwarce
- 2020: Google Translate dostaje koder transformerowy z dekoderem RNN
- 2022: ChatGPT na bazie GPT-3.5 wywołuje boom na duże modele językowe
Jak działa uwaga w transformerze
Opis dotyczy oryginalnego transformera koder-dekoder z pracy z 2017 roku.
- Tokenizacja: Tekst dzieli się na tokeny: słowa, podsłowa lub bajty
- Osadzenie: Token zamienia się w wektor, do którego dodaje się pozycję
- Q, K, V: Z wektorów powstają zapytania, klucze i wartości
- Uwaga: Iloczyn zapytań i kluczy, softmax, ważona suma wartości
- Wiele głowic: Głowice liczą równolegle, wyniki idą do warstwy feedforward
Źródło: Wikipedia: Transformer (deep learning)
Dla każdej jednostki uwagi model uczy się trzech macierzy wag: zapytań (WQ), kluczy (WK) i wartości (WV). Waga uwagi od tokenu i do tokenu j to iloczyn skalarny wektora zapytania i wektora klucza. Wagi dzieli się przez pierwiastek z wymiaru kluczy, co stabilizuje gradienty, i przepuszcza przez softmax. Wynik dla tokenu to suma wektorów wartości, ważona tymi wagami. Ponieważ WQ i WK to różne macierze, uwaga nie jest symetryczna. Jeśli token i silnie „patrzy” na token j, nie musi to działać w drugą stronę.
Pozycja tokenu
Sama uwaga nie zależy od kolejności tokenów, więc transformer dodaje informację o pozycji. Oryginalny model używał stałych kodowań sinusoidalnych, z parametrem N = 10 000, i według hasła dawał podobne wyniki jak uczone osadzenia pozycji. Dzięki temu zdania „man bites dog” i „dog bites man” są przetwarzane inaczej.
Wiele głowic
Jeden zestaw macierzy (WQ, WK, WV) to głowica uwagi, a każda warstwa ma ich wiele. Każda głowica może inaczej definiować, co jest „istotne” dla danego tokenu. Wyniki głowic łączy się i przekazuje do sieci feedforward. Hasło podaje przykład najmniejszego modelu GPT-2: wymiar osadzenia 768, 12 głowic po 64 wymiary, a 12 × 64 = 768. Warstwy feedforward zawierają większość parametrów modelu. W GPT-2 i BERT ich warstwa środkowa jest czterokrotnie szersza niż wymiar osadzenia.
| Cecha | RNN / LSTM | Transformer |
|---|---|---|
| Przetwarzanie tokenów | jeden token naraz, od pierwszego do ostatniego | równolegle po pozycjach (w treningu) |
| Dostęp do wcześniejszych słów | przez poprzedni stan | bezpośredni do dowolnej części zdania |
Trening: rozgrzewka, regularyzacja, wiele GPU
Oryginalna praca stosowała rozgrzewkę współczynnika uczenia: rósł liniowo przez pierwsze 4000 kroków, a potem malał według harmonogramu odwrotnego pierwiastka. Normalizacja warstw przed podwarstwami (pre-LN, zamiast użytej w oryginale post-LN) może w niektórych ustawieniach poprawić stabilność i zmniejszyć zależność od rozgrzewki. Jako regularyzację oryginał stosował dropout oraz label smoothing.
Duże modele trenuje się na wielu GPU lub innych akceleratorach, bo parametry, aktywacje i dane mogą nie zmieścić się na jednym urządzeniu. Stosuje się równoległość danych, modelu, tensorów i potoku. Modele językowe zwykle wstępnie trenuje się na dużych korpusach metodami samonadzorowanymi, a część z nich dostraja do konkretnych zadań. Hasło wymienia trzy klasy zadań: maskowane, autoregresyjne i prefixLM.
Granice: kwadratowy koszt i spór o interpretację
Transformer pozwala równolegle przetwarzać tokeny w trakcie treningu, ale standardowa uwaga ma koszt obliczeniowy i pamięciowy rosnący kwadratowo z długością sekwencji. Rozmiar macierzy uwagi jest proporcjonalny do kwadratu liczby tokenów, więc przy długim wejściu potrzeba dużo pamięci GPU. Flash attention zmniejsza zapotrzebowanie na pamięć bez utraty dokładności, dzieląc obliczenia na mniejsze bloki mieszczące się w szybkiej pamięci układu. Osobną rodziną rozwiązań jest uwaga liniowa. Jej warianty, takie jak DeltaNet, Mamba czy RetNet, hasło o uwadze opisuje jako próby obniżenia kosztu.
Hasła nie podają porównawczych wyników jakości tych wariantów względem standardowej uwagi, więc nie wynika z nich, który jest lepszy.
Pytania i odpowiedzi
Czym różni się BERT od GPT?
BERT to model typu encoder-only, trenowany do przewidywania zamaskowanych tokenów. Seria GPT to dekodery trenowane autoregresyjnie, czyli przewidujące każdy token na podstawie poprzedzającego kontekstu. W treningu autoregresyjnym maska przyczynowa zabrania patrzeć na późniejsze tokeny, a mimo to sekwencję można przetwarzać równolegle.
Czy transformer działa tylko na tekście?
Nie. Hasło wymienia zastosowania w przetwarzaniu języka, widzeniu komputerowym, uczeniu ze wzmocnieniem, audio, uczeniu multimodalnym, robotyce i grze w szachy. Vision transformer przetwarza fragmenty obrazu jako ciąg tokenów. Cztery dni po publikacji pracy z 2017 roku większość jej autorów opublikowała multimodalną architekturę MultiModel.
Czy mapy uwagi wyjaśniają decyzje modelu?
Nie zawsze. W vision transformerach wizualizacja wyników uwagi jako mapy cieplnej stała się rutynowym sposobem podglądu modelu, ale hasło zaznacza, że wyższe wartości uwagi nie zawsze odpowiadają większemu wpływowi na wyniki modelu. Używanie uwagi jako wyjaśnienia jest przedmiotem sporu.
Źródła
Piotr Olszewski
Autor Przełomowego. Codziennie czyta prace z arXiv, Nature, Science i komunikaty uczelni, a opisuje tylko te, które coś zmieniają. Każdą liczbę podaje ze źródłem.
Jak wybieram i sprawdzam prace →Widzisz błąd albo nieścisłość? Napisz - poprawię i dopiszę datę aktualizacji.