Test 10 modeli AI w zakupach: więcej rozumowania podnosi pewność, nie trafność wyboru
Autorzy preprintu przetestowali 10 modeli AI na trzech zestawach zakupowych. Wyższy poziom rozumowania w WebShop poprawił wynik istotnie tylko u trzech modeli, a pewność siebie podniósł u dziewięciu z dziesięciu.
- Badanie objęło 10 modeli językowych i trzy zestawy zadań zakupowych: WebShop, Amazon SQID i Wayfair WANDS.
- Po przejściu z niskiego na wysoki poziom rozumowania trafność wyboru zmieniała się niewiele. W WebShop istotnie poprawiły się tylko trzy modele, w pozostałych zestawach jeszcze mniej.
- Deklarowana pewność istotnie wzrosła u 9 z 10 modeli w WebShop, u 5 w SQID i u 6 w WANDS.
- Większość modeli nie jest dobrze skalibrowana na każdym poziomie rozumowania. Gdy kilka modeli się myli, często wybiera ten sam zły produkt.
- To preprint, który nie przeszedł recenzji. Zadanie było uproszczone: wybór jednego produktu z dziesięciu.
Dłuższe "myślenie" modelu nie sprawia, że agent zakupowy wybiera lepsze produkty. Sprawia za to, że częściej deklaruje, że jest pewny swojej decyzji. Do takiego wniosku doszli Adi Krishnamoorthy i X.Y. Han z University of Chicago w preprincie z 17 listopada 2026 r. Sprawdzili, czy parametr "reasoning effort" (niski, średni, wysoki), który dostępny jest w nowoczesnych modelach, przekłada się na jakość zakupowych decyzji.
Przeczytałem abstrakt oraz wstęp, przegląd literatury i opis metod. Fragment pełnego tekstu, do którego miałem dostęp, urywa się na opisie modeli. Dlatego nie podaję wielkości efektów ani wartości wskaźników, tylko to, co autorzy opisują słowami i liczbą modeli.
Dziesięć produktów, jedna dobra odpowiedź
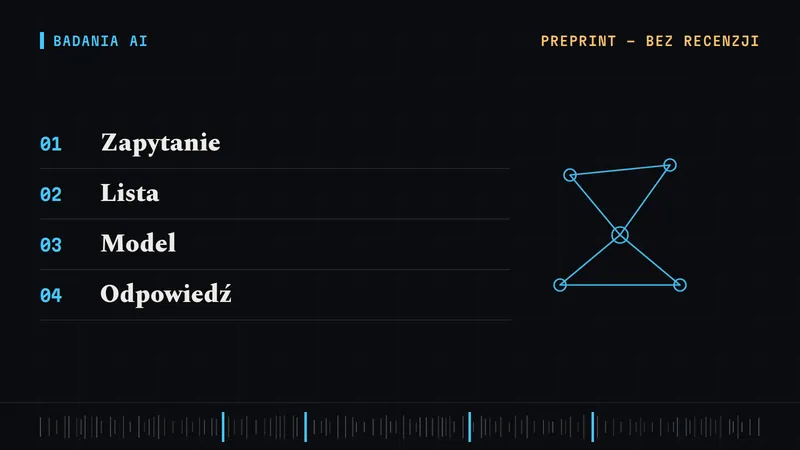
Autorzy celowo uprościli zadanie. Każde zadanie to zapytanie zakupowe i ustawiona w losowej kolejności lista dziesięciu produktów, z których dokładnie jeden jest poprawny. Taka konstrukcja usuwa z eksperymentu wyszukiwanie i nawigowanie po sklepie, więc każdy model na każdym poziomie rozumowania decyduje na tych samych danych. Pozwala to porównać model z samym sobą, zadanie po zadaniu.
- Zapytanie: Krótka fraza zakupowa lub instrukcja z wymaganiami
- Lista: Dziesięć kandydatów w losowej kolejności, jeden poprawny
- Model: Ten sam prompt, poziom rozumowania: niski, średni lub wysoki
- Odpowiedź: Wybór produktu i deklarowana pewność w procentach
- Ocena: Porównanie wyboru z etykietą poprawnego produktu
Źródło: Krishnamoorthy, Han, arXiv:2611.22033
Zadania zbudowano na trzech zestawach:
- WebShop (obrazy i tekst). Poprawny wybór to taki, który dostaje maksymalną nagrodę 1 za zgodność atrybutów, opcji i ceny z instrukcją. Po odrzuceniu instrukcji z mniej niż dziewięcioma pasującymi "zmyłkami" zostało 496 zadań.
- Amazon SQID (obrazy i tekst). Poprawny jest produkt z etykietą Exact, a dziewięć zmyłek to produkty oznaczone przez adnotatorów jako Substitute lub Complement. Z 3541 kwalifikujących się zapytań zbudowano 500 zadań.
- Wayfair WANDS (sam tekst, bez zdjęć, cen i opcji). Poprawny jest produkt z etykietą Exact, a dziewięć zmyłek to produkty oznaczone jako Partial. Kwalifikowało się 350 z 480 zapytań, z czego 330 trafiło do zestawu testowego, a 20 odłożono na próbę pilotażową.
Modele i sposób ustawiania wysiłku
Autorzy porównali dziesięć modeli od sześciu dostawców: OpenAI, Anthropic, Google, DeepSeek, Alibaba i Moonshot. Wszystkie odpytywano przez API OpenRouter z identycznymi promptami i wspólnym limitem 16 000 tokenów na rozumowanie i odpowiedź. Poziom wysiłku ustawiano parametrem reasoning.effort. DeepSeek V4.1 Flash i Kimi K3 dopuszczają tylko poziom niski i wysoki, więc porównanie z poziomem średnim nie dotyczy wszystkich modeli.
Pewność rośnie szybciej niż trafność
Najważniejszy wynik dotyczy przejścia z niskiego na wysoki poziom rozumowania. Trafność zmieniała się nieznacznie: w WebShop istotnie poprawiły się tylko trzy modele, a w dwóch pozostałych zestawach jeszcze mniej. Deklarowana pewność rosła natomiast wyraźnie częściej.
| WebShop | 9 z 10 modeli |
|---|---|
| SQID | 5 z 10 modeli |
| WANDS | 6 z 10 modeli |
Źródło: Krishnamoorthy, Han, arXiv:2611.22033
Autorzy ujmują to tak: dodatkowe myślenie "kupuje" pewność, a nie poprawność. Warto jednak zauważyć, że brak istotnej statystycznie poprawy nie dowodzi, że efekt wynosi zero. Mówi tylko, że w tej próbie zadań nie dało się go wiarygodnie odróżnić od zera.
Kalibracja zależy od modelu, nie od wysiłku
Kalibracja oznacza tu zgodność między deklarowaną pewnością a faktyczną skutecznością. Autorzy mierzyli ją wskaźnikami ECE, Brier i AUROC. Piszą, że zależy ona niemal wyłącznie od modelu, a większość modeli nie jest dobrze skalibrowana na każdym poziomie wysiłku. Część z nich jest stale wyraźnie pewniejsza siebie niż inne, choć nie trafniejsza.
Błędy się powtarzają
Pomyłki nie są losowe. Liczba modeli, które mylą się w danym zadaniu, jest znacznie bardziej skupiona, niż wynikałoby z założenia, że modele mylą się niezależnie. Gdy kilka modeli popełnia błąd w tym samym zadaniu, zwykle wybiera ten sam zły produkt. Z perspektywy kupującego oznacza to, że "zapytanie drugiego modelu" nie jest dobrym zabezpieczeniem.
Ograniczenia
To preprint, który nie przeszedł recenzji. Zadania są uproszczone: wybór z dziesięciu gotowych kandydatów, bez wyszukiwania i nawigacji, więc wyników nie należy wprost przenosić na agentów kupujących w prawdziwych sklepach. W SQID i WANDS poprawna odpowiedź to ludzka adnotacja, a autorzy przyznają, że część etykiet Exact jest dyskusyjna. Ich zdaniem obniża to wynik wszystkich modeli i nie zaburza porównań. Pewność była deklarowana słownie przez model, a nie odczytywana z prawdopodobieństw tokenów.
Pytania i odpowiedzi
Czy dłuższe rozumowanie nigdy nie pomaga modelom?
Autorzy odnoszą wniosek do decyzji zakupowych. Powołują się na wcześniejsze prace, według których dodatkowa moc obliczeniowa w trakcie odpowiedzi poprawia wyniki w matematyce i programowaniu.
Jakich wskaźników użyto do oceny kalibracji?
Zastosowano ECE, wynik Briera i AUROC. Pierwsze dwa mierzą rozbieżność między deklarowaną pewnością a faktyczną skutecznością, a AUROC pokazuje, na ile pewność odróżnia dobre odpowiedzi od złych.
Które modele przetestowano?
Wśród dziesięciu modeli były GPT-6 Astra, GPT-6.1 Sol, GPT-6 Luna, Claude Fable 5.1, Claude Opus 5.5, Gemini 4 Argon, Gemini 3.1 Pro, DeepSeek V4.1 Flash, Qwen 3.8 Max i Kimi K3.
Źródła
- Adi Krishnamoorthy, X.Y. Han, Thinking Harder Doesn't Lead to Better Choices: Reasoning Effort Increases the Confidence but Not the Correctness of LLM Shopping Agents, arXiv (preprint), 2026-11-17
- arXiv cs.AI - strona pracy arXiv:2611.22033, 2026-11-17
Piotr Olszewski
Autor Przełomowego. Codziennie czyta prace z arXiv, Nature, Science i komunikaty uczelni, a opisuje tylko te, które coś zmieniają. Każdą liczbę podaje ze źródłem.
Jak wybieram i sprawdzam prace →Widzisz błąd albo nieścisłość? Napisz - poprawię i dopiszę datę aktualizacji.